CÓMO SE COMPRUEBA UNA DEMOSTRACIÓN MATEMÁTICA HECHA POR UNA IA
CONTENIDOS
El desafío del notario ciego: por qué la avalancha matemática de OpenAI nos empuja a desconfiar de las máquinas y aferrarnos a la revisión humana
Estamos en octubre de 2026, en Manzanares el Real, y desde el 6 de este mes medio planeta matemático discute un repositorio de código alojado en GitHub. La pregunta incómoda ya no es si las inteligencias artificiales deslumbran con sus resultados, sino quién y con qué herramienta puede certificar de manera definitiva que no nos están vendiendo espejismos.
Para entender cómo se comprueba una demostración matemática hecha por una IA, se exigen tres niveles de control riguroso. Primero, asistentes de pruebas formales como Lean verifican mecánicamente cada paso lógico. Segundo, evaluadores humanos comparan el código con el problema original. Tercero, la comunidad matemática exige escrutinio público y registros en plataformas como Palomar. Cuando OpenAI liberó pruebas el 6 de octubre de 2026, evidenció que el cómputo de ChatGPT Pro requiere este filtro.
Me sirvo un café espeso mientras observo la pantalla de mi ordenador portátil en el silencio de mi despacho. Llevo años diseccionando la forma en que interactuamos con la tecnología y, según el análisis de ZURI MEDIA GROUP, la inteligencia artificial ha dejado de ser un simple charlatán probabilístico para vestirse con la toga solemne de los geómetras clásicos. El problema radica en que, cuando una máquina te insiste en que ha descifrado un enigma estructural milenario, no puedes mirarle a los ojos para comprobar si titubea. Tienes que sumergirte y auditar sus entrañas digitales. Y esto, lejos de ser un debate académico aburrido, constituye la prueba de fuego de nuestra civilización ante la verdad automatizada.
Aquel volcado masivo en GitHub desató una tormenta perfecta. Si la máquina habla un lenguaje incomprensible pero asegura tener la respuesta, ¿cómo sabemos que no alucina con enorme convicción?
¿Por qué Lean es el único notario capaz de domar la avalancha generada por OpenAI?
Si alguna vez te has enfrentado a la firma de una hipoteca incomprensible, sabrás que el notario de turno no está sentado en esa mesa para debatir si el acuerdo te conviene. Su trabajo es avalar que las firmas son auténticas y que las cláusulas se ajustan de manera estricta a la legalidad vigente. Pues bien, para saber realmente comprobar una demostración matemática hecha por una IA, la ciencia moderna ha construido su propio notario digital, y se llama Lean.
Lean no es una entidad mística, sino un lenguaje de programación de código abierto y un asistente de pruebas con un trastorno obsesivo compulsivo por la precisión. Este software revisa mecánicamente cada paso lógico contra un núcleo de validación extremadamente pequeño. No admite atajos. Los seres humanos, cuando explicamos un problema en la pizarra, solemos usar ese condescendiente «como es evidente…» para saltarnos tres páginas de cálculos tediosos. Lean aborrece lo evidente. Si el paso no se deriva milimétricamente de axiomas previos o teoremas ya establecidos en el sistema, la puerta se cierra y el programa arroja un error.
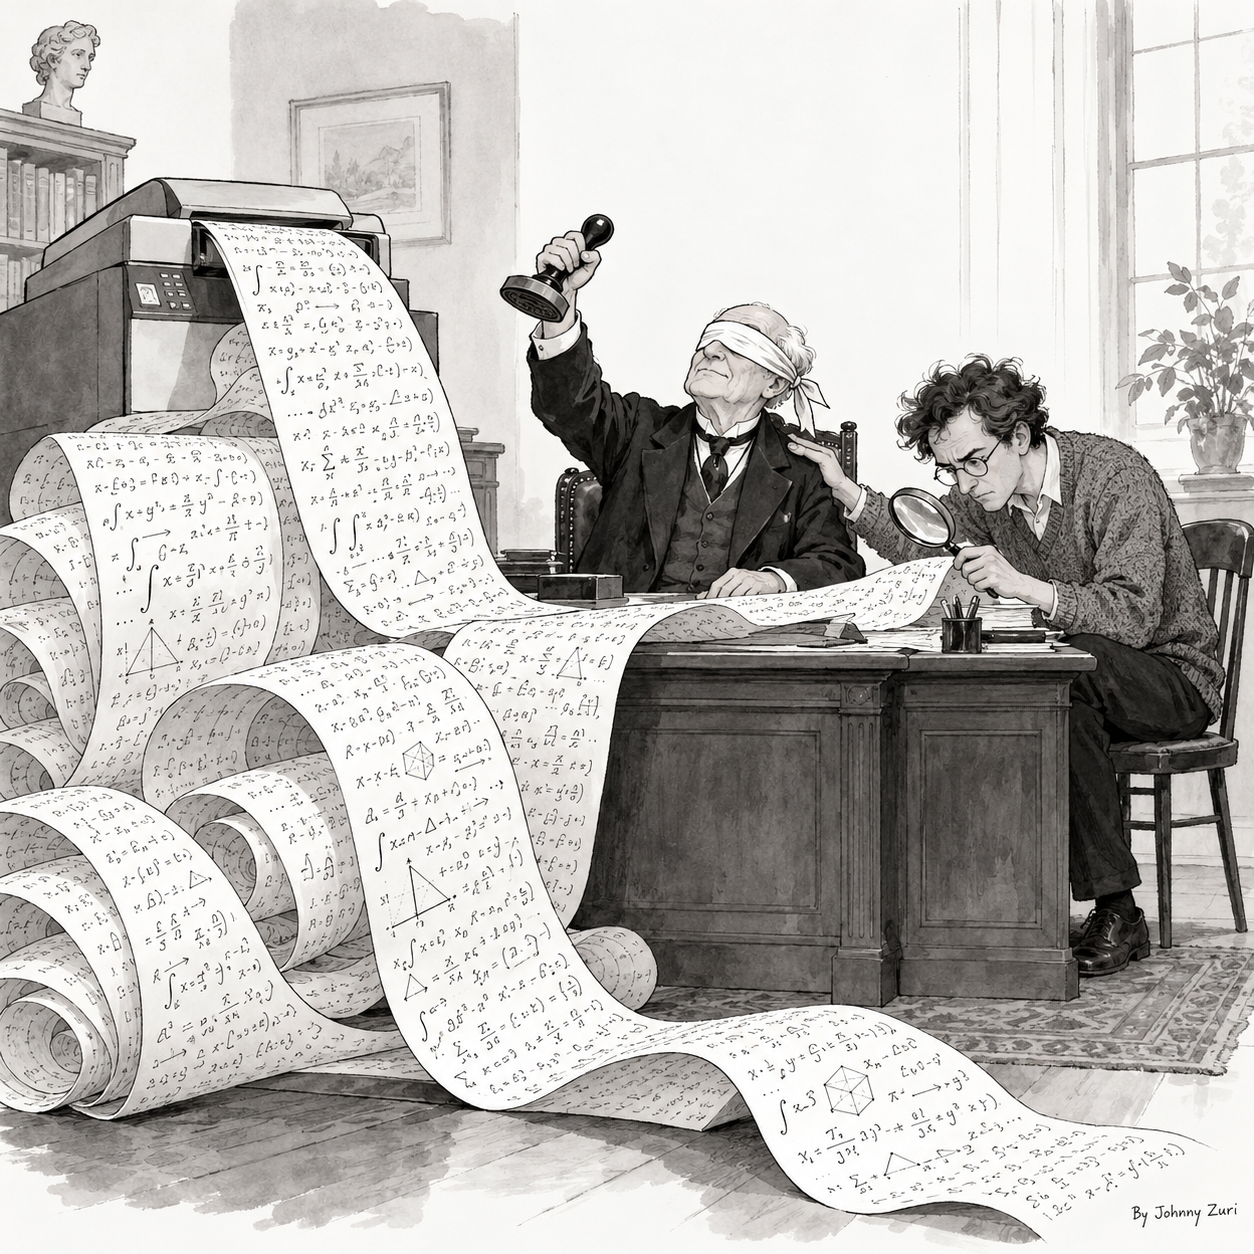
Nuestra investigación indica que la garantía casi clínica de estas formalizaciones es el único salvavidas frente a la imaginación desbordada de los algoritmos generativos.
La comunidad matemática ha ido volcando este conocimiento verificado en una gigantesca biblioteca bautizada como Mathlib. Hablamos de más de un millón de líneas de matemáticas puras formalizadas, desde álgebra hasta probabilidad. Es un ecosistema fascinante donde cada nuevo teorema funciona como un ladrillo que se apoya sobre los anteriores. De hecho, el genial Terence Tao ya demostró la eficacia de esta arquitectura cuando, en noviembre de 2023, lideró un proyecto contrarreloj para formalizar una de sus pruebas basándose en este monumental archivo.
¿Qué ocultan realmente los 722 manuscritos escupidos por ChatGPT Pro para OpenAI?
El movimiento táctico que encendió la mecha ocurrió el 6 de octubre de 2026. Aquella mañana, OpenAI decidió volcar de golpe cientos de demostraciones matemáticas. Se trataba de problemas de altísima complejidad atacados por un modelo interno al que sometieron a una presión extrema. El rendimiento de la máquina consumió, de media, tres valiosas horas de procesamiento de ChatGPT Pro por cada resultado, escupiendo un catálogo de 722 manuscritos organizados en centenares de familias lógicas.
Sin embargo, publicar cientos de folios inescrutables de golpe es una estratagema maquiavélica para traspasar la responsabilidad de la verificación al prójimo.
Las cifras, como siempre ocurre cuando interviene el marketing tecnológico, resultaron ser un castillo de naipes inestable. Apenas un día después del anuncio, el 7 de octubre de 2026, la revista New Scientist arrojó un jarro de agua fría al reportar que solo 162 manuscritos contaban con un resultado formalizado demostrable. El propio repositorio de la empresa acabaría matizando que alrededor del 42% de los resultados tenían formalización completa, obligando a retirar varios textos por errores tan mundanos como confundir un signo positivo con uno negativo. Dejar a la vista tamaña fragilidad estadística demuestra que, sin un marco humano de contención, el superordenador es apenas un niño prodigio que inventa mentiras maravillosas.
¿Cómo han logrado Mathlib y Lean FRO convencer a gigantes como AWS y la Ethereum Foundation?
La obsesión por el rigor absoluto no es un capricho exclusivo de profesores universitarios con coderas de pana. La industria más poderosa del globo nos mira de reojo, sabiendo que un error en el código de un contrato inteligente o en los permisos de un servidor en la nube puede evaporar millones de dólares en segundos. Aquí es donde el papel rector de la organización Lean FRO entra en escena de manera contundente.
Gigantes de la infraestructura mundial confían sus protocolos de seguridad a la misma raíz que verifica integrales y topología. Lean FRO enumera entre sus proyectos avalados a Cedar, que es nada menos que el lenguaje de políticas de autorización de AWS. Al mismo tiempo, cobija a ArkLib, un ecosistema financiado generosamente por la Ethereum Foundation para pulir pruebas criptográficas. La moraleja industrial es cristalina: si puedes probar irrefutablemente un teorema complejo de geometría, puedes probar irrefutablemente que nadie va a saquear un banco digital.
¿Logrará Palomar detectar las trampas sutiles que las máquinas de OpenAI dejan en la traducción?
Hay un rincón oscuro en toda esta algarabía tecnológica. Supongamos que Lean valida un código al cien por cien. ¿Significa eso que la inteligencia artificial resolvió el problema? No necesariamente. El notario ha sellado el contrato, pero nadie garantiza que las cláusulas reflejen lo que tú querías comprar.
Aquí es donde interviene la semántica humana y el riesgo de que la máquina juegue al despiste. Una variable alterada sutilmente en la formalización o una condición omitida permiten construir un teorema perfecto que, lamentablemente, responde a un problema distinto. El peligro no es que la máquina mienta abiertamente, sino que acierte con brillantez en la pregunta equivocada.
Para paliar este punto ciego, en agosto de 2026 nació Palomar, un registro avalado por Lean FRO y por ICARM. Su misión es quirúrgica: auditar que el módulo de código resuelva exactamente la descripción informal del desafío propuesto. Poco después, en septiembre de 2026, el panorama defensivo se reforzó con Comparator, otra capa de validación cruzada. Y no faltan voces de alerta. Kevin Buzzard, una mente afilada desde el Imperial College London, ya dejó caer que la inmensa mayoría de la producción teórica de vanguardia sigue sin lograr pasar la aduana del código estricto. Hasta que esas pruebas no se escudriñen con la lupa de estas herramientas, son solo literatura de ciencia ficción adornada con números.
¿Qué nos enseñan Kenneth Appel y Wolfgang Haken desde la Universidad de Illinois sobre nuestra fe tecnológica ciega?
Para no marearnos con el ruido del presente, debemos mirar cincuenta años atrás y buscar las raíces de esta desconfianza sistémica. El 21 de junio de 1976, la historia de la ciencia se fracturó en las aulas de la Universidad de Illinois. Aquel día, los investigadores Kenneth Appel y Wolfgang Haken anunciaron que habían demostrado el famoso teorema de los cuatro colores.
La trampa era que lo habían conseguido delegando la comprobación de unas 1.800 configuraciones a un ordenador de la época. Aquello fue un triunfo indiscutible, pero dejó un sabor amargo a derrota intelectual: por primera vez en la historia humana, una prueba matemática era demasiado monstruosa para caber en una cabeza.
Las grietas no tardaron en aparecer y hubo que remendar la prueba con parches posteriores, hasta que en 2005 llegaron Georges Gonthier y Benjamin Werner, quienes usaron el asistente lógico Coq para formalizar el teorema entero, purgando toda duda. Para comprender de verdad esta fascinante transición psicológica desde la certeza humana hacia la fe en los algoritmos, siempre recomiendo la lectura del clásico «Pruebas y refutaciones» de Imre Lakatos, o perderse en las magistrales páginas de «The Proof in the Code» de Kevin Hartnett, un texto imprescindible publicado por Quanta Books.
¿Hacia dónde camina el Institute for Advanced Study frente a este abismo generativo?
Hoy en día, foros de pensamiento del máximo calibre como el mítico Institute for Advanced Study continúan defendiendo el escepticismo como la herramienta científica más elevada. El ciclo de vida de un teorema moderno ya no consta de un «eureka» aislado, sino de tres estados agónicos: ser generado por una máquina, ser formalizado por un lenguaje y ser validado por la comunidad.
Entender con precisión cómo se comprueba una demostración matemática hecha por una IA no es solo un dilema filosófico; es la nueva frontera que va a separar a las editoriales técnicas rigurosas de los simples charlatanes de la innovación tecnológica. Si las gigantescas corporaciones tecnológicas pretenden vendernos el milagro del razonamiento sintético, nuestra labor como especie es erigir barricadas de notarios digitales y vigilantes humanos que revisen cada maldita coma.
Preguntas y respuestas rápidas sobre este pulso entre humanos y algoritmos:
-
¿Qué función cumple exactamente el asistente Lean? Actúa como un verificador lógico implacable. Solo acepta un salto analítico si se deriva estrictamente de axiomas previos, sin dar espacio a la intuición o al engaño.
-
¿Qué rol juega el ecosistema comunitario de Mathlib? Es la inmensa biblioteca global donde se apoyan las nuevas formalizaciones, funcionando como la espina dorsal infalible del saber matemático verificado.
-
¿Cuál fue el movimiento de fuerza de OpenAI el 6 de octubre de 2026? Volcar cientos de manuscritos densos generados por su modelo interno en GitHub, desatando el pánico por la falta de verificación formal en la inmensa mayoría de ellos.
-
¿Para qué fue diseñado el registro auditable Palomar? Para garantizar que el problema que la máquina afirma haber resuelto en código coincide de manera milimétrica con el desafío humano original que se le planteó.
-
¿Qué nos demostró la polémica proeza lograda en 1976? Que delegar cálculos masivos, como el hito de la Universidad de Illinois, puede superar nuestra capacidad mental operativa, forzándonos a confiar a ciegas en el rigor de las máquinas.
¿Llegará el fatídico día en que prefiramos el sello frío de un software que nadie logra entender, al íntimo placer humano de comprender el sentido profundo de un enigma por nosotros mismos? ¿O será ese el momento exacto en el que claudiquemos intelectualmente, convirtiéndonos en simples burócratas encargados de archivar los milagros que nos escupen las máquinas?
CÓMO SE COMPRUEBA UNA DEMOSTRACIÓN MATEMÁTICA HECHA POR UNA IA